PCA qua SVD: dẫn xuất, độ ổn định số và nén dữ liệu cảm biến
1. Bối cảnh
Một nút IoT đọc nhiều cảm biến tương quan với nhau (nhiệt độ, độ ẩm, rung ở nhiều vị trí) thường có ít nguồn biến thiên thật hơn số kênh. Khi đó có thể gửi vài điểm số thay cho cả vector đo, và dùng phần dữ liệu không giải thích được bởi các điểm số đó để nhận ra cảm biến hỏng. Phân tích thành phần chính (PCA) là công cụ chuẩn cho cả hai việc: Pearson (1901) xét đường và mặt phẳng khớp nhất với một đám điểm, Hotelling (1933) đặt tên và dẫn xuất theo phương sai, còn Jolliffe và Cadima (2016) tổng quan các biến thể. Bài này dẫn xuất PCA từ SVD, kiểm tra các đẳng thức bằng số, so sánh hai cách tính về độ ổn định, rồi đo trên một mảng cảm biến mô phỏng.
2. Dẫn xuất
Gọi \(X\in\mathbb{R}^{n\times d}\) là \(n\) mẫu của \(d\) kênh, \(\mu\) là vector trung bình theo cột và \(X_c=X-\mathbf 1\mu^\top\) là ma trận đã trừ trung bình. Ma trận hiệp phương sai mẫu là \(S=X_c^\top X_c/(n-1)\). Hướng đơn vị \(v\) làm phương sai của hình chiếu lớn nhất là nghiệm của
$$\max_{\|v\|=1}\ \operatorname{Var}(X_c v)=\max_{\|v\|=1}\ v^\top S v,$$và đó là vector riêng của \(S\) ứng với trị riêng lớn nhất (nhân tử Lagrange cho \(Sv=\lambda v\), phương sai đạt được bằng \(\lambda\)). Hướng thứ hai làm tương tự trong phần bù trực giao, và cứ thế. Viết SVD gọn của \(X_c\):
$$X_c=U\Sigma V^\top,\qquad U^\top U=V^\top V=I,\quad \Sigma=\operatorname{diag}(\sigma_1\ge\sigma_2\ge\dots\ge0).$$Thay vào \(S\): \(S=V\,\dfrac{\Sigma^2}{n-1}\,V^\top\). Vậy các trục chính là các cột của \(V\), phương sai tương ứng là
$$\lambda_i=\frac{\sigma_i^2}{n-1},$$và các điểm số (tọa độ trên các trục) là \(T=X_cV=U\Sigma\). Giữ \(k\) thành phần cho xấp xỉ \(\hat X_k=X_cV_kV_k^\top\) hạng \(k\). Định lý Eckart–Young (1936) nói \(\hat X_k\) là ma trận hạng không quá \(k\) gần \(X_c\) nhất theo chuẩn Frobenius và
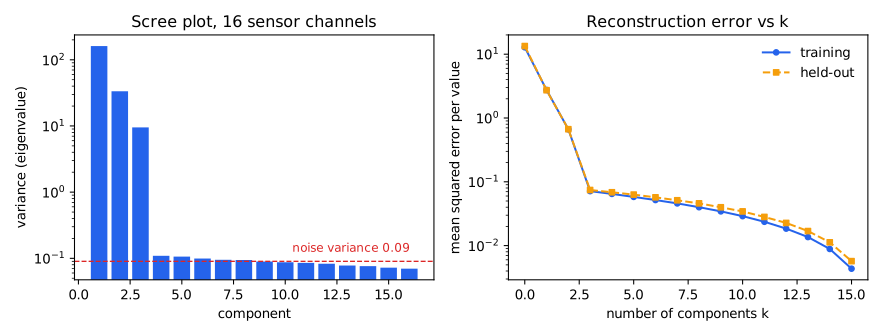
$$\|X_c-\hat X_k\|_F^2=\sum_{i>k}\sigma_i^2,\qquad \text{tỉ lệ phương sai giải thích}=\frac{\sum_{i\le k}\sigma_i^2}{\sum_i\sigma_i^2}.$$Như vậy sai số tái tạo nhìn thấy ngay từ phổ kỳ dị: đồ thị sườn dốc (scree) vừa cho biết nên giữ bao nhiêu thành phần, vừa cho biết sẽ mất bao nhiêu.
Phần dư và phát hiện lỗi. Với một mẫu mới \(x\), phần dư là \(r=(I-V_kV_k^\top)(x-\mu)\) và \(Q=\|r\|^2\) (thống kê Q, còn gọi SPE). Jackson và Mudholkar (1979) nghiên cứu cách dùng Q để kiểm soát chất lượng: nếu mô hình \(k\) thành phần còn đúng thì \(Q\) nhỏ, còn một cảm biến lệch khỏi quan hệ tương quan thông thường làm \(Q\) tăng. Nếu lỗi là độ lệch \(\delta\) cộng vào kênh \(c\), phần dư của riêng độ lệch đó có bình phương chuẩn
$$\delta^2\Bigl(1-\sum_{j\le k}V_{cj}^2\Bigr),$$nên kênh có tải lớn trên các thành phần chính (tổng \(\sum_{j\le k}V_{cj}^2\) gần 1) “giấu” một phần độ lệch trong không gian con và khó phát hiện hơn.
3. Hai cách tính và độ ổn định số
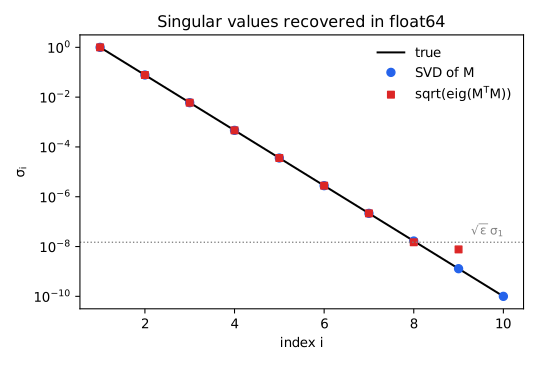
Cách 1: SVD của \(X_c\). Cách 2: lập \(S=X_c^\top X_c/(n-1)\) rồi giải bài toán trị riêng đối xứng. Về đại số chúng bằng nhau, nhưng việc lập \(X_c^\top X_c\) bình phương số điều kiện: \(\kappa(X_c^\top X_c)=\kappa(X_c)^2\). Bộ giải trị riêng đối xứng cho trị riêng với sai số tuyệt đối cỡ \(\varepsilon\,\|S\|\) (\(\varepsilon\approx2{,}2\cdot10^{-16}\) với float64), nên trị kỳ dị \(\sigma_i=\sqrt{\lambda_i}\) nhỏ hơn khoảng \(\sqrt{\varepsilon}\,\sigma_1\approx1{,}5\cdot10^{-8}\sigma_1\) sẽ mất hết chữ số có nghĩa; SVD trực tiếp giữ được sai số tuyệt đối cỡ \(\varepsilon\,\sigma_1\) (Golub và Van Loan, 2013). Điều này liên quan trực tiếp đến bài gradient descent và số điều kiện, nơi cùng hiện tượng bình phương \(\kappa\) làm chậm hội tụ.
4. Cài đặt
Script đầy đủ (sinh dữ liệu, bốn thí nghiệm, hai hình; chạy khoảng 2 giây) tải về được. Phần lõi:
def pca_svd(X, k):
    """PCA of the rows of X via thin SVD of the centred matrix."""
    mu = X.mean(0)
    _, s, Vt = np.linalg.svd(X - mu, full_matrices=False)
    return mu, Vt[:k], s                         # lambda_i = s_i**2 / (n - 1)

def pca_cov(X, k):
    """PCA via eigendecomposition of the sample covariance (forms X^T X)."""
    mu = X.mean(0)
    Xc = X - mu
    w, V = np.linalg.eigh(Xc.T @ Xc / (len(X) - 1))
    order = np.argsort(w)[::-1]
    return mu, V[:, order[:k]].T, w[order]

def reconstruct(X, mu, comps):
    return (X - mu) @ comps.T @ comps + mu

# Q statistic (SPE) of each row, threshold = 99th percentile of the training Q
spe = lambda X: np.sum((X - reconstruct(X, mu, comps)) ** 2, 1)
5. Thiết lập thí nghiệm
Dữ liệu (tổng hợp, tái lập hoàn toàn). \(d=16\) kênh cảm biến chịu chi phối bởi \(k=3\) nguồn tiềm ẩn Gaussian độc lập với độ lệch chuẩn 3, 2 và 1. Ma trận tải \(A\in\mathbb{R}^{16\times3}\) lấy Gaussian chuẩn, mỗi kênh có độ lệch riêng (độ lệch chuẩn 2) và nhiễu Gaussian độc lập độ lệch chuẩn 0,3: \(x=Az+\text{offset}+\text{nhiễu}\). Mỗi seed (0–19) sinh ma trận tải mới, 1.000 mẫu huấn luyện và 1.000 mẫu kiểm tra mới. Mô hình khớp trên tập huấn luyện; mọi sai số báo cáo ở Mục 7 tính trên tập kiểm tra.
6. Kiểm tra tính đúng (seed 0)
- Hai cách trùng nhau trên dữ liệu điều kiện tốt. \(\max_i|\sigma_i^2/(n-1)-\lambda_i|=8{,}5\cdot10^{-14}\) trên cả 16 giá trị và, sau khi chỉnh dấu, vector của 3 thành phần đầu lệch nhau tối đa \(8{,}6\cdot10^{-16}\). Trị riêng đầu của hiệp phương sai là 161,3; 33,41; 9,502 rồi 0,1092; 0,1062; 0,09915: ba thành phần đầu chiếm 99,44 % tổng phương sai và phần còn lại nằm sát phương sai nhiễu \(0{,}3^2=0{,}09\).
- Đẳng thức Eckart–Young. \(\|X_c-\hat X_k\|_F^2\) và \(\sum_{i>k}\sigma_i^2\) trùng tới mọi chữ số in ra:
\(k\) \(\|X_c-\hat X_k\|_F^2\) \(\sum_{i>k}\sigma_i^2\) 1 44.014,109772 44.014,109772 2 10.635,719080 10.635,719080 3 1.143,290310 1.143,290310 5 928,087154 928,087154 8 639,974303 639,974303
7. Thí nghiệm 1: nén và phát hiện lỗi trên dữ liệu giữ lại
| Đại lượng (\(k=3\), trung bình ± độ lệch chuẩn trên 20 seed) | Kết quả |
|---|---|
| RMSE tái tạo mỗi giá trị trên tập giữ lại | 0,2708 ± 0,0015 (kỳ vọng chỉ có nhiễu: \(0{,}3\sqrt{13/16}=0{,}2704\)) |
| Lưu trữ | 16 số thực thành 3 điểm số mỗi mẫu (nhỏ hơn 5,33 lần), cộng cơ sở 3×16 lưu một lần |
| Báo động nhầm trên dữ liệu bình thường giữ lại (ngưỡng = phân vị 99 của Q huấn luyện) | 1,27 % ± 0,37 % (mục tiêu 1 %) |
Với \(k\) bằng đúng số nguồn thật, phần dư còn lại gần như chỉ là nhiễu: nhiễu có \(d\) thành phần độc lập, phép chiếu giữ lại \(k\) trong số đó nên phần dư chứa trung bình \(\sigma_n^2(d-k)/d\) mỗi giá trị, tức RMSE \(0{,}3\sqrt{13/16}=0{,}2704\), sát với giá trị đo 0,2708. Mức báo động nhầm 1,27 % hơi cao hơn mục tiêu 1 %, phù hợp với việc ngưỡng được ước lượng từ phần dư của chính tập dùng để khớp mô hình.
Phát hiện lỗi lệch một kênh. Trên tập kiểm tra, cộng độ lệch \(\delta\) vào một kênh (thử lần lượt cả 16 kênh) rồi tính tỉ lệ mẫu có \(Q\) vượt ngưỡng:
| Độ lệch \(\delta\) (so với độ lệch chuẩn nhiễu 0,3) | Tỉ lệ phát hiện, trung bình trên 16 kênh | Kênh khó nhất (trung bình trên 20 seed) |
|---|---|---|
| 0,5 (1,7×) | 4,0 % ± 0,6 | 2,5 % |
| 1,0 (3,3×) | 23,9 % ± 2,1 | 11,6 % |
| 2,0 (6,7×) | 94,8 % ± 1,0 | 74,2 % |
| 3,0 (10×) | 99,9 % ± 0,2 | 98,7 % |
- Lỗi nhỏ gần như không phát hiện được: độ lệch 1,7 lần độ lệch chuẩn nhiễu chỉ được phát hiện 4 % số mẫu; từ khoảng 7 lần trở lên tỉ lệ vượt 94 % trung bình.
- Kênh khác nhau cho kết quả khác nhau. Ở \(\delta=2\), kênh khó nhất chỉ đạt 74,2 % so với 94,8 % trung bình, đúng hướng của công thức \(\delta^2(1-\sum_{j\le k}V_{cj}^2)\) ở Mục 2: phần độ lệch rơi vào không gian con của các thành phần chính không để lại phần dư.
8. Thí nghiệm 2: khi cách tính qua hiệp phương sai hỏng
Dựng ma trận \(M=U\operatorname{diag}(\sigma)V^\top\) cỡ 200×10 với \(U,V\) là các ma trận trực giao ngẫu nhiên và \(\sigma\) từ 1 xuống \(10^{-10}\) theo thang log (\(\kappa(M)=10^{10}\), \(\kappa(M^\top M)=10^{20}\)), rồi khôi phục \(\sigma\) bằng hai cách:
| \(i\) | \(\sigma_i\) thật | Sai số tương đối, SVD của \(M\) | Sai số tương đối, \(\sqrt{\text{trị riêng}(M^\top M)}\) |
|---|---|---|---|
| 1 | 1,000e+00 | 1,1e-16 | 1,1e-16 |
| 2 | 7,743e-02 | 1,8e-16 | 2,5e-15 |
| 3 | 5,995e-03 | 4,3e-16 | 6,1e-13 |
| 4 | 4,642e-04 | 8,2e-16 | 8,9e-12 |
| 5 | 3,594e-05 | 1,4e-13 | 5,3e-09 |
| 6 | 2,783e-06 | 1,9e-12 | 1,5e-06 |
| 7 | 2,154e-07 | 5,7e-12 | 9,1e-05 |
| 8 | 1,668e-08 | 2,2e-10 | 1,1e-01 |
| 9 | 1,292e-09 | 1,3e-09 | 4,9e+00 |
| 10 | 1,000e-10 | 9,4e-09 | 1,0e+00 (trị riêng tính được là −2,93e-17, bị cắt về 0) |
- SVD giữ sai số tuyệt đối dưới \(\varepsilon\sigma_1\). Sai số tương đối tăng khi \(\sigma_i\) nhỏ dần nhưng sai số tuyệt đối vẫn rất nhỏ (cỡ \(10^{-18}\) ở \(i=8\) và \(9\)), đúng với mức \(\varepsilon\sigma_1=2{,}2\cdot10^{-16}\) làm cận.
- Đường qua hiệp phương sai mất độ chính xác từ \(i=6\) (sai số tương đối \(1{,}5\cdot10^{-6}\)) và hỏng hẳn từ \(i=8\): \(\sigma_8=1{,}7\cdot10^{-8}\) sát ngưỡng \(\sqrt{\varepsilon}\sigma_1=1{,}5\cdot10^{-8}\), sai số 11 %; \(\sigma_9\) sai gấp gần 6 lần; \(\sigma_{10}^2=10^{-20}\) nằm dưới nhiễu số \(\varepsilon\sigma_1^2=2{,}2\cdot10^{-16}\) nên trị riêng tính được là số âm.
Hạn chế. Dữ liệu là tổng hợp, Gaussian, đúng 3 nguồn tiềm ẩn với nhiễu độc lập cùng độ lớn; cảm biến thật có nhiễu không Gaussian, trôi theo thời gian và phân phối thay đổi theo điều kiện. \(k=3\) được biết trước; thực tế phải chọn \(k\) từ đồ thị sườn dốc hoặc kiểm chứng chéo. Ngưỡng của Q lấy theo phân vị thực nghiệm của tập huấn luyện, không dùng xấp xỉ giải tích của Jackson và Mudholkar; tập huấn luyện được giả định không chứa lỗi. Chỉ thử một loại lỗi (lệch cố định ở một kênh), không thử cảm biến kẹt, trôi chậm hay nhiều kênh hỏng cùng lúc. PCA là tuyến tính; quan hệ phi tuyến giữa các kênh cần phương pháp khác. Thí nghiệm ổn định số dùng ma trận dựng riêng với \(\kappa=10^{10}\), cực đoan hơn dữ liệu cảm biến ở Mục 6 (tỉ số trị kỳ dị lớn nhất trên nhỏ nhất chỉ khoảng 40, nên hai cách tính trùng nhau). Không đo thời gian chạy hay năng lượng trên thiết bị nhúng.
9. Kết luận thực hành
- Tính PCA bằng SVD của ma trận đã trừ trung bình; các trục là cột \(V\), phương sai là \(\sigma_i^2/(n-1)\), điểm số là \(U\Sigma\).
- Đọc sai số tái tạo từ phổ kỳ dị: \(\sum_{i>k}\sigma_i^2\) là sai số bình phương tối thiểu cho mọi xấp xỉ hạng \(k\).
- Qua ma trận hiệp phương sai vẫn dùng được khi các trị kỳ dị quan tâm lớn hơn khoảng \(10^{-8}\sigma_1\); dưới ngưỡng đó, dùng SVD.
- Khi đã có mô hình \(k\) thành phần, thống kê Q của phần dư là một bộ phát hiện lỗi cảm biến rẻ: ở đây báo động nhầm 1,3 % và phát hiện hơn 94 % độ lệch bằng 6,7 lần độ lệch chuẩn nhiễu, nhưng chỉ 4 % độ lệch 1,7 lần.
- Kiểm tra từng kênh một: kênh có tải lớn trên các thành phần chính khó phát hiện lỗi hơn đáng kể.
Tôi nhận làm với tư cách freelancer. Mô tả dự án trong vài câu, tôi sẽ trả lời bằng các câu hỏi và báo giá trọn gói theo phạm vi cố định.
Nhận báo giá Xem dịch vụ
Tài liệu tham khảo
- K. Pearson. “On lines and planes of closest fit to systems of points in space.” The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, loạt 6, tập 2, số 11, 1901, tr. 559–572. doi:10.1080/14786440109462720.
- H. Hotelling. “Analysis of a complex of statistical variables into principal components.” Journal of Educational Psychology 24(6), 1933, tr. 417–441. doi:10.1037/h0071325.
- C. Eckart và G. Young. “The approximation of one matrix by another of lower rank.” Psychometrika 1(3), 1936, tr. 211–218. doi:10.1007/BF02288367.
- J. E. Jackson và G. S. Mudholkar. “Control procedures for residuals associated with principal component analysis.” Technometrics 21(3), 1979, tr. 341–349. doi:10.1080/00401706.1979.10489779.
- I. T. Jolliffe và J. Cadima. “Principal component analysis: a review and recent developments.” Philosophical Transactions of the Royal Society A 374(2065), 20150202, 2016. doi:10.1098/rsta.2015.0202.
- G. H. Golub và C. F. Van Loan. Matrix Computations, xuất bản lần 4. Johns Hopkins University Press, 2013. ISBN 978-1-4214-0794-4.