Gradient descent và số điều kiện: vì sao bình phương tối thiểu chạy chậm
1. Bối cảnh
Hồi quy tuyến tính thường là mô hình đầu tiên người ta học, còn gradient descent là bộ tối ưu đầu tiên. Ghép hai thứ này lại có một điều bất ngờ: cùng một tập dữ liệu có thể cần mười vòng lặp hoặc một triệu vòng lặp, chỉ phụ thuộc vào cách co giãn các đặc trưng. Đại lượng quyết định là số điều kiện của ma trận Hessian. Bài thuật toán 8 điểm đã gặp chính đại lượng này dưới một dạng khác: toạ độ pixel thô cho ma trận điều kiện kém, và chuẩn hoá làm số điều kiện giảm từ \(4.6\times10^{5}\) xuống 18. Bài này dẫn xuất tốc độ hội tụ của gradient descent trên một hàm bậc hai, so sánh với conjugate gradient, và đo điều gì xảy ra với một bài hồi quy trước và sau khi chuẩn hoá.
2. Gradient descent trên hàm bậc hai
Xét mô hình bậc hai
$$f(\mathbf x)=\tfrac12\,\mathbf x^\top A\,\mathbf x-\mathbf b^\top\mathbf x,\qquad A=A^\top\succ 0,$$với các giá trị riêng \(0<\lambda_1\le\dots\le\lambda_d\), điểm cực tiểu \(\mathbf x^\star=A^{-1}\mathbf b\) và sai số \(\mathbf e_k=\mathbf x_k-\mathbf x^\star\). Gradient là \(\nabla f(\mathbf x)=A\mathbf x-\mathbf b=A\,(\mathbf x-\mathbf x^\star)\), nên gradient descent với bước cố định \(\alpha\) cho
$$\mathbf x_{k+1}=\mathbf x_k-\alpha\nabla f(\mathbf x_k)\quad\Longrightarrow\quad \mathbf e_{k+1}=(I-\alpha A)\,\mathbf e_k\quad\Longrightarrow\quad \mathbf e_k=(I-\alpha A)^k\mathbf e_0 .$$Trong cơ sở riêng của \(A\), mỗi thành phần của sai số được nhân với \((1-\alpha\lambda_i)^k\). Vòng lặp hội tụ khi và chỉ khi \(|1-\alpha\lambda_i|<1\) với mọi \(i\), tức \(0<\alpha<2/\lambda_d\). Thành phần chậm nhất quyết định tốc độ:
$$\rho(\alpha)=\max_i|1-\alpha\lambda_i|=\max\bigl(|1-\alpha\lambda_1|,\;|1-\alpha\lambda_d|\bigr).$$Số hạng đầu giảm theo \(\alpha\), số hạng thứ hai tăng khi \(\alpha>1/\lambda_d\), nên cực tiểu đạt được khi hai số hạng bằng nhau về độ lớn và ngược dấu, \(1-\alpha\lambda_1=-(1-\alpha\lambda_d)\):
$$\alpha^\star=\frac{2}{\lambda_1+\lambda_d},\qquad \rho^\star=\frac{\lambda_d-\lambda_1}{\lambda_d+\lambda_1}=\frac{\kappa-1}{\kappa+1},\qquad \kappa=\frac{\lambda_d}{\lambda_1}.$$Vì \(I-\alpha A\) giao hoán với \(A\) và có chuẩn phổ bằng \(\rho\), sai số đo bằng chuẩn năng lượng \(\|\mathbf e\|_A=\sqrt{\mathbf e^\top A\mathbf e}\) thoả
$$\|\mathbf e_k\|_A\le\rho^{k}\,\|\mathbf e_0\|_A .$$Để giảm sai số đi \(\varepsilon\) lần cần \(k\ge \ln(1/\varepsilon)/\ln(1/\rho)\). Với \(\kappa\) lớn, \(\ln\frac{\kappa+1}{\kappa-1}\approx 2/\kappa\), nên
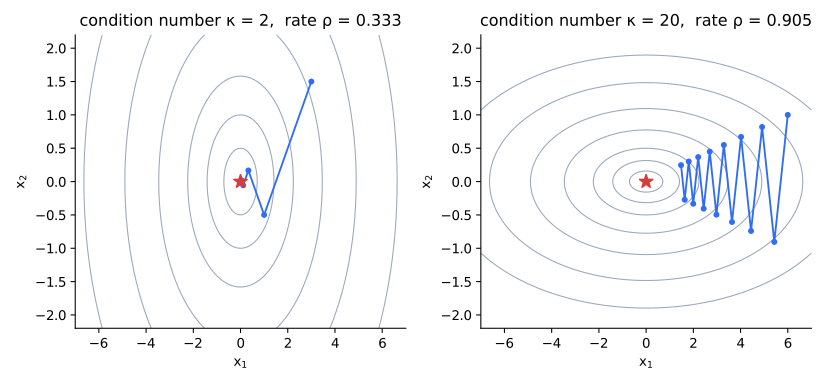
$$k\;\approx\;\frac{\kappa}{2}\,\ln\frac1\varepsilon .$$Số vòng lặp tỉ lệ tuyến tính với số điều kiện. Hình 1 cho thấy lý do: theo hướng dốc, bước nhảy vượt quá và đổi dấu liên tục; theo hướng thoải, nó hầu như không tiến.
3. Conjugate gradient: \(\sqrt\kappa\) thay vì \(\kappa\)
Phương pháp conjugate gradient (Hestenes & Stiefel, 1952) giải \(A\mathbf x=\mathbf b\) với chi phí mỗi vòng lặp bằng gradient descent, một phép nhân với \(A\), nhưng dựng mỗi hướng tìm kiếm sao cho \(A\)-trực giao với các hướng trước. Trong số học chính xác, nó kết thúc sau nhiều nhất \(d\) bước, và sai số thoả chặn (Shewchuk, 1994, công thức 52)
$$\|\mathbf e_k\|_A\le 2\left(\frac{\sqrt\kappa-1}{\sqrt\kappa+1}\right)^{k}\|\mathbf e_0\|_A ,$$suy ra cần khoảng \(k\approx\frac{\sqrt\kappa}{2}\ln\frac2\varepsilon\) vòng lặp. Số điều kiện đi vào qua căn bậc hai của nó.
4. Bình phương tối thiểu là hàm bậc hai, và Hessian bình phương điều kiện số
Với ma trận thiết kế \(X\in\mathbb R^{n\times d}\), hàm mất mát \(\frac1{2n}\|X\mathbf w-\mathbf y\|^2\) là hàm bậc hai với \(A=X^\top X/n\) và \(\mathbf b=X^\top\mathbf y/n\). Các giá trị riêng của \(X^\top X\) là bình phương các giá trị suy biến của \(X\), do đó
$$\kappa(A)=\kappa(X)^2 .$$Các đặc trưng có thang đo rất khác nhau, hoặc có trung bình lớn đi cùng phương sai nhỏ, làm \(\kappa(X)\) lớn và \(\kappa(A)\) bằng bình phương của nó. Hai bước tiền xử lý xử lý vấn đề này. Căn giữa mỗi đặc trưng làm nó trực giao với cột hệ số chặn, vì \(X_{\cdot j}^\top\mathbf 1=0\); khi đó \(A\) trở thành ma trận khối chéo \(\mathrm{diag}\bigl(1,\,C\bigr)\), với \(C\) là ma trận hiệp phương sai mẫu của các đặc trưng. Co giãn mỗi đặc trưng về phương sai đơn vị biến \(C\) thành ma trận tương quan, có đường chéo toàn số 1. Nếu các đặc trưng gần như không tương quan thì \(C\approx I\) và \(\kappa\approx1\).
5. Cài đặt
Hai bộ giải bằng NumPy. Script đầy đủ, gồm cả hai thí nghiệm và hai hình, có thể tải về.
import numpy as np

def a_norm(A, e):
    return float(np.sqrt(e @ (A @ e)))

def gd_iters(A, b, x_star, step, tol=1e-6, cap=300_000):
    """Gradient descent bước cố định từ x0=0; dừng khi ||e_k||_A <= tol * ||e_0||_A."""
    x = np.zeros_like(b)
    e0 = a_norm(A, x - x_star)
    for k in range(1, cap + 1):
        x = x - step * (A @ x - b)
        ratio = a_norm(A, x - x_star) / e0
        if ratio <= tol:
            return k, ratio
    return None, ratio

def cg_iters(A, b, x_star, tol=1e-6, cap=100_000):
    """Conjugate gradient từ x0=0 với cùng điều kiện dừng."""
    x = np.zeros_like(b); r = b - A @ x; p = r.copy(); rs = r @ r
    e0 = a_norm(A, x - x_star)
    for k in range(1, cap + 1):
        Ap = A @ p
        alpha = rs / (p @ Ap)
        x = x + alpha * p
        r = r - alpha * Ap
        if a_norm(A, x - x_star) <= tol * e0:
            return k
        rs_new = r @ r
        p = r + (rs_new / rs) * p
        rs = rs_new
    return None
Kiểm tra tính đúng đắn
Trên hàm bậc hai 2 chiều \(\mathrm{diag}(1,50)\) với bước tối ưu, chuẩn sai số sau 25 bước chia cho chuẩn ban đầu là \(0.3678304\), trùng với \(\rho^{25}=(49/51)^{25}\) tới các chữ số in ra: với ma trận này tốc độ đạt đúng bằng \(\rho\), không chỉ bị chặn bởi nó.
6. Thí nghiệm 1: gradient descent so với conjugate gradient
Thiết lập (dữ liệu tổng hợp, tái lập hoàn toàn). Với mỗi \(\kappa\in\{10,10^2,10^3,10^4\}\), \(A=Q\,\mathrm{diag}(\lambda)\,Q^\top\) với \(d=100\), \(Q\) trực giao ngẫu nhiên và các giá trị riêng cách đều theo thang log từ 1 đến \(\kappa\); \(\mathbf b\) chuẩn tắc, \(\mathbf x_0=\mathbf 0\), NumPy seed 3. Gradient descent dùng bước cố định tối ưu \(2/(\lambda_1+\lambda_d)\). Tôi đếm số vòng lặp cho tới khi \(\|\mathbf e_k\|_A\le10^{-6}\|\mathbf e_0\|_A\) và so với chặn: \(\lceil\ln(10^{-6})/\ln\rho\rceil\) cho gradient descent và \(\lceil\ln(10^{-6}/2)/\ln q\rceil\) cho conjugate gradient, với \(q=(\sqrt\kappa-1)/(\sqrt\kappa+1)\).
| κ | Chặn GD | GD đo được | Chặn CG | CG đo được |
|---|---|---|---|---|
| 10 | 69 | 60 | 23 | 21 |
| 100 | 691 | 633 | 73 | 59 |
| 1.000 | 6.908 | 6.241 | 230 | 131 |
| 10.000 | 69.078 | 59.014 | 726 | 272 |
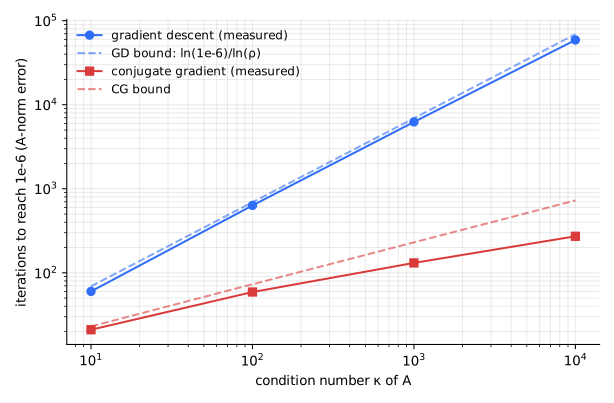
- Gradient descent tăng tuyến tính theo \(\kappa\). Mỗi lần \(\kappa\) tăng 10 lần, số vòng lặp đo được tăng khoảng 10 lần (60, 633, 6.241, 59.014) và luôn nằm dưới chặn.
- Conjugate gradient tăng xấp xỉ theo \(\sqrt\kappa\). Từ \(\kappa=10\) đến \(10^4\), số vòng lặp đo được tăng từ 21 lên 272, gấp 13 lần, trong khi \(\sqrt\kappa\) tăng gấp 32 lần; nó luôn dưới chặn và thấp hơn hẳn ở \(\kappa\) lớn; Shewchuk lưu ý CG thường tốt hơn chặn khi phân bố giá trị riêng thuận lợi.
- Tại \(\kappa=10^4\), khoảng cách là 59.014 so với 272 vòng lặp, khoảng 217 lần, với cùng chi phí mỗi vòng lặp.
7. Thí nghiệm 2: chuẩn hoá đặc trưng trong bài hồi quy
Thiết lập (dữ liệu tổng hợp, tái lập hoàn toàn). \(n=2000\) “căn nhà” với hệ số chặn và bốn đặc trưng: diện tích \(\sim\mathcal N(100,30^2)\), số phòng đều trên \(\{1,\dots,6\}\), tuổi nhà \(\sim U(0,50)\), khoảng cách \(\sim\mathcal N(5,2^2)\); mục tiêu \(y=X\mathbf w+\mathcal N(0,5^2)\) với \(\mathbf w=(20,\,1.5,\,4,\,-0.3,\,-2)\) (NumPy seed 5). Hàm mất mát \(\frac1{2n}\|X\mathbf w-\mathbf y\|^2\), \(A=X^\top X/n\), bắt đầu từ \(\mathbf w=\mathbf 0\), bước cố định tối ưu, cùng điều kiện dừng, giới hạn 300.000 vòng lặp. Ba phiên bản của cùng dữ liệu: thô, căn giữa, và căn giữa kèm co giãn về phương sai đơn vị.
| Đặc trưng | κ(A) | Chặn GD | GD đo được | CG đo được |
|---|---|---|---|---|
| thô | 3,04×10⁵ | 2.099.254 | chưa đạt sau 300.000 (tỉ lệ sai số 0,139) | 6 |
| căn giữa | 866,0 | 5.983 | 5.982 | 5 |
| căn giữa + phương sai đơn vị | 1,087 | 5 | 4 | 4 |
- Đặc trưng thô: các giá trị riêng của \(A\) trải từ 0,0382 đến 11.615, \(\kappa=3{,}04\times10^5\). Sau 300.000 vòng lặp, gradient descent mới giảm sai số theo chuẩn \(A\) xuống còn 13,9% ban đầu; chặn dự đoán cần khoảng 2,1 triệu vòng lặp để đạt \(10^{-6}\).
- Chỉ căn giữa đã giảm \(\kappa\) khoảng 350 lần (xuống 866), và gradient descent cần 5.982 vòng lặp, chỉ lệch một vòng so với chặn.
- Căn giữa và co giãn cho \(\kappa=1{,}087\): bốn vòng lặp, vì các đặc trưng ở đây gần như không tương quan nên \(A\) gần với ma trận đơn vị.
- Conjugate gradient cần 4–6 vòng lặp trong mọi trường hợp. Với \(d=5\) ẩn, số học chính xác sẽ kết thúc sau nhiều nhất 5 bước; con số 6 ở dữ liệu thô phù hợp với sai số làm tròn dấu phẩy động ở \(\kappa\approx3\times10^5\).
Hạn chế. Cả hai thí nghiệm đều là hàm bậc hai, nơi \(\kappa\) không đổi; với hàm mất mát phi bậc hai, ma trận liên quan là Hessian cục bộ và nó thay đổi dọc đường đi. Bước tối ưu dùng chính xác các giá trị riêng cực trị, điều hiếm khi biết trước; với bước an toàn như \(1/\lambda_d\), tốc độ là \(1-1/\kappa\), còn chậm hơn. Các đặc trưng trong Thí nghiệm 2 gần như không tương quan nên chuẩn hoá đưa \(\kappa\) về gần 1; đặc trưng tương quan mạnh vẫn điều kiện kém sau chuẩn hoá, vì khi đó \(C\) có giá trị riêng nhỏ. Không có chính quy hoá, vốn cũng chặn dưới \(\lambda_1\). Toàn bộ dữ liệu là tổng hợp.
8. Điều rút ra trong thực hành
- Căn giữa và co giãn đặc trưng trước khi dùng bất kỳ bộ giải dựa trên gradient nào cho mô hình tuyến tính hoặc tuyến tính suy rộng. Chỉ tốn hai dòng mã mà có thể đổi số vòng lặp theo nhiều bậc độ lớn.
- Nhớ rằng \(\kappa(X^\top X)=\kappa(X)^2\): khi giải trực tiếp bình phương tối thiểu, nên dùng QR hoặc SVD thay cho phương trình chuẩn, giống lập luận về toạ độ trong bài thuật toán 8 điểm.
- Với bài toán bậc hai lớn, thưa hoặc có cấu trúc, conjugate gradient trả giá \(\sqrt\kappa\) thay vì \(\kappa\) với một phép nhân ma trận-vector mỗi vòng lặp.
- Khi huấn luyện chậm hơn mong đợi, hãy xem số điều kiện (hay tỉ số giá trị riêng lớn nhất trên nhỏ nhất của Hessian) trước khi chỉnh learning rate.
- Kiểm tra tương quan sau khi chuẩn hoá: chúng quyết định số điều kiện còn lại.
Tôi nhận làm các việc này với tư cách freelancer. Hãy mô tả dự án trong vài câu, tôi sẽ phản hồi bằng các câu hỏi làm rõ và báo giá theo phạm vi cố định.
Nhận báo giá Xem dịch vụ
Tài liệu tham khảo
- M. R. Hestenes and E. Stiefel. “Methods of conjugate gradients for solving linear systems.” Journal of Research of the National Bureau of Standards 49(6):409–436, December 1952 (Research Paper 2379). PDF.
- J. R. Shewchuk. “An Introduction to the Conjugate Gradient Method Without the Agonizing Pain.” School of Computer Science, Carnegie Mellon University, edition 1¼, August 4, 1994. Trang tác giả. (Hội tụ của steepest descent và conjugate gradient theo số điều kiện; chặn có hệ số 2 là công thức 52.)
- S. Boyd and L. Vandenberghe. Convex Optimization. Cambridge University Press, 2004. Trang sách. (Chương 9: gradient descent cho hàm lồi mạnh.)
- R. I. Hartley. “In defense of the eight-point algorithm.” IEEE TPAMI 19(6):580–593, 1997. doi:10.1109/34.601246.