Lượng tử hoá int8 cho edge AI: từ công thức đến sai số đo được
1. Bối cảnh
Một mô hình chạy được trên vi điều khiển phải tôn trọng hai ngân sách: bộ nhớ flash/RAM cho trọng số và năng lượng cho mỗi phép nhân-cộng. Lưu mỗi trọng số bằng 8 bit thay vì 32 bit giảm bộ nhớ trọng số khoảng bốn lần, và khối nhân-cộng số nguyên rẻ hơn khối số thực dấu phẩy động; Jacob và cộng sự (2018) mô tả một sơ đồ trong đó cả trọng số lẫn kích hoạt đều là số nguyên 8 bit và suy luận chỉ dùng số học nguyên. Các vi điều khiển có bộ tăng tốc nơ-ron trên chip công bố trong tháng này, như STM32H7P với NPU Neural-ART, hướng tới việc chạy mô hình ngay trên thiết bị. Bài này dẫn xuất bộ lượng tử hoá, trình bày phép tính số nguyên của một tầng dense, và đo xem chuyển đổi int8 sau huấn luyện làm mất bao nhiêu độ chính xác trên bài toán giám sát tình trạng máy, kể cả khi lưới thô đi nhiều.
2. Bộ lượng tử hoá affine
Một giá trị thực \(x\) trong đoạn \([\alpha,\beta]\) được ánh xạ sang số nguyên \(q\) có \(b\) bit, với hệ số tỉ lệ \(s\) và điểm không \(z\):
$$q=\operatorname{clip}\bigl(\operatorname{round}(x/s)+z,\;q_{\min},q_{\max}\bigr),\qquad \hat x=s\,(q-z),\qquad s=\frac{\beta-\alpha}{2^{b}-1},\quad z=\operatorname{round}\!\left(-\frac{\alpha}{s}\right).$$Khi \(\alpha\le0\le\beta\), giá trị 0 được biểu diễn chính xác (\(q=z\)); điều này quan trọng vì đầu ra ReLU và phần đệm bằng 0 đều là số 0 đúng. Với kích hoạt không dấu, \(q\in[0,255]\). Với trọng số tôi dùng biến thể đối xứng: \(z=0\), \(q\in[-(2^{b-1}-1),\,2^{b-1}-1]\) và \(s=\max|w|/(2^{b-1}-1)\); với \(b=8\) đó là \([-127,127]\).
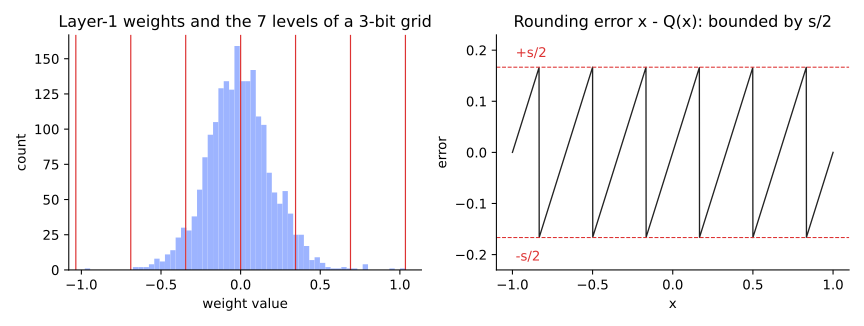
Sai số. Trong đoạn giá trị, phép làm tròn dịch \(x\) tối đa nửa bước, \(|x-\hat x|\le s/2\). Nếu sai số làm tròn xấp xỉ phân bố đều trên \([-s/2,s/2]\) thì phương sai của nó là \(s^2/12\). Với tín hiệu phân bố đều trên cả đoạn \(R=\beta-\alpha\), phương sai tín hiệu là \(R^2/12\) và, với \(s\approx R/2^{b}\), tỉ số tín hiệu trên nhiễu lượng tử hoá là
$$\mathrm{SQNR}=10\log_{10}\frac{R^2/12}{s^2/12}\approx 10\log_{10}2^{2b}=6{,}02\,b\ \text{dB}.$$Vậy mỗi bit thêm vào cho khoảng 6 dB. Trọng số thật có phân bố hình chuông và đoạn giá trị do giá trị lớn nhất quyết định, nên phần lớn trọng số chỉ dùng một phần nhỏ của lưới và SQNR đo được thấp hơn \(6{,}02\,b\) (Mục 7).
3. Phép tính số nguyên của một tầng dense
Với đầu ra \(i\) của tầng dense, \(y_i=\sum_j W_{ij}x_j+b_i\). Thay \(W_{ij}=s_{w,i}\,q^w_{ij}\) (đối xứng, một hệ số cho mỗi hàng đầu ra, hoặc cùng một hệ số cho mọi hàng) và \(x_j=s_x\,(q^x_j-z_x)\):
$$y_i=s_{w,i}\,s_x\Bigl[\;\sum_j q^w_{ij}\,\bigl(q^x_j-z_x\bigr)+q^b_i\Bigr],\qquad q^b_i=\operatorname{round}\!\left(\frac{b_i}{s_{w,i}\,s_x}\right).$$Biểu thức trong ngoặc vuông là số nguyên, tính bằng toán hạng 8 bit và bộ cộng dồn 32 bit. Mỗi số hạng có độ lớn tối đa \(127\cdot255=32.385\), nên bộ cộng dồn 32 bit có dấu không tràn với tích vô hướng ít hơn \(2^{31}/32.385\approx66.000\) số hạng; các tầng ở đây có 64, 32 và 16 đầu vào. Đầu vào tầng kế tiếp thu được bằng cách nhân bộ cộng dồn với \(M=s_{w,i}s_x/s_y\) rồi cộng điểm không đầu ra; trên thiết bị thật, \(M\) được lưu dưới dạng hệ số nhân số nguyên dấu phẩy tĩnh kèm phép dịch bit (Jacob và cs., 2018). Trong mô phỏng của bài này, phép nhân với \(M\) làm bằng số thực dấu phẩy động, mọi bước trước đó làm bằng số nguyên.
Độ mịn của hệ số. Lượng tử hoá theo tensor (per-tensor) dùng một hệ số \(s_w\) cho cả ma trận; theo kênh (per-channel) dùng một hệ số cho mỗi hàng đầu ra, nên hàng có trọng số nhỏ không bị ép vào lưới của hàng có trọng số lớn nhất. Krishnamoorthi (2018) khuyến nghị trọng số per-channel cùng kích hoạt per-layer làm sơ đồ ưu tiên cho phần cứng. Đoạn giá trị kích hoạt \([\alpha,\beta]\) lấy từ bước hiệu chỉnh (calibration): chạy vài trăm đầu vào đại diện qua mô hình số thực và ghi giá trị nhỏ nhất, lớn nhất của từng tầng.
4. Cài đặt
Ba hàm cốt lõi bằng NumPy. Script đầy đủ (sinh dữ liệu, huấn luyện, cả ba thí nghiệm và hai hình) tải về được.
def quant_weights(W, bits, per_channel):
    """Symmetric signed quantization, zero-point 0. Returns integers and the scale(s), shape (out,)."""
    qmax = 2 ** (bits - 1) - 1
    amax = np.abs(W).max(1) if per_channel else np.full(W.shape[0], np.abs(W).max())
    s = np.maximum(amax, 1e-12) / qmax
    q = np.clip(np.round(W / s[:, None]), -qmax, qmax).astype(np.int32)
    return q, s

def act_params(lo, hi, bits=8):
    """Asymmetric unsigned quantization of a range that always contains 0."""
    lo, hi = min(lo, 0.0), max(hi, 0.0)
    s = max(hi - lo, 1e-12) / (2 ** bits - 1)
    z = int(np.clip(round(-lo / s), 0, 2 ** bits - 1))
    return s, z

def quant_forward(P, X, wbits=8, per_channel=True, abits=8, cal=None):
    cal = cal or calibrate(P, X, abits)
    qmax_a = 2 ** abits - 1
    s_x, z_x = cal[0]
    xq = np.clip(np.round(X / s_x) + z_x, 0, qmax_a).astype(np.int32)
    for i, (W, b) in enumerate(P):
        wq, s_w = quant_weights(W, wbits, per_channel)
        bq = np.round(b / (s_w * s_x)).astype(np.int64)                 # int32 bias, scale s_w*s_x
        acc = (xq - z_x).astype(np.int64) @ wq.T.astype(np.int64) + bq  # integer accumulation
        y = acc * (s_w * s_x)
        if i == len(P) - 1:
            return y
        y = np.maximum(y, 0)
        s_x, z_x = cal[i + 1]
        xq = np.clip(np.round(y / s_x) + z_x, 0, qmax_a).astype(np.int32)
Kiểm tra tính đúng
Lượng tử hoá 100.000 giá trị phân bố đều trên \([-1{,}3;\,2{,}1]\) xuống 8 bit cho \(s=0{,}013333\), \(z=97\) và sai số khứ hồi lớn nhất 0,006667, bằng \(s/2\) tới các chữ số đã in: cận ở Mục 2 đạt được chứ không chỉ được tôn trọng.
5. Thiết lập thí nghiệm
Bài toán (dữ liệu tổng hợp, tái lập được hoàn toàn). Các cửa sổ 128 mẫu ở 1.024 Hz của một máy quay, ba lớp: bình thường (sóng sin ở tần số quay lấy ngẫu nhiên trong 28–32 Hz), mất cân bằng (như trên cộng hài bậc hai biên độ 0,2–0,6), và hỏng ổ bi (như trên cộng các xung 300 Hz tắt dần lặp ở 3,2–3,8 lần tần số quay, biên độ 0,5–1,5). Thêm nhiễu Gaussian độ lệch chuẩn 0,3, pha ngẫu nhiên. Đặc trưng là \(\log(1+|\mathrm{FFT}|)\) của cửa sổ đã nhân hàm Hann, lấy 64 bin đầu, chuẩn hoá theo thống kê tập huấn luyện.
Mô hình. MLP 64→32→16→3 với ReLU (2.659 tham số), huấn luyện bằng Adam (tốc độ học 0,003, batch 128, 40 epoch) trong NumPy. Với mỗi trong 12 seed (0–11), sinh một tập huấn luyện mới và một tập kiểm tra mới, mỗi tập 3.000 cửa sổ, cùng một khởi tạo mới. 256 cửa sổ huấn luyện đầu tiên dùng để hiệu chỉnh đoạn giá trị kích hoạt. Mọi độ chính xác nêu bên dưới tính trên 3.000 cửa sổ kiểm tra. Mô hình số thực tham chiếu là float64 của NumPy; dung lượng bộ nhớ bên dưới tính theo float32.
6. Thí nghiệm 1: int8 so với số thực
| Mô hình | Độ chính xác kiểm tra (trung bình ± độ lệch chuẩn, 12 seed) | Dự đoán trùng mô hình số thực | Sai số logit tương đối trung bình |
|---|---|---|---|
| số thực (fp64) | 93,83 ± 0,29 % | — | — |
| int8, trọng số per-tensor | 93,84 ± 0,31 % | 99,84 % | 0,0092 |
| int8, trọng số per-channel | 93,83 ± 0,28 % | 99,87 % | 0,0080 |
- Ở đây int8 gần như không gây mất mát. Theo từng seed, mức giảm độ chính xác so với số thực tối đa 0,13 điểm (per-tensor) và 0,07 điểm (per-channel); mức giảm trung bình là −0,011 và 0,000 điểm, tức không có thay đổi đo được. Dự đoán trùng mô hình số thực trên 99,84–99,87 % số cửa sổ kiểm tra.
- Per-channel chính xác hơn một chút về mặt số học (sai số logit tương đối trung bình 0,0080 so với 0,0092, thấp hơn 13 %), nhưng ở 8 bit chênh lệch độ chính xác nhỏ hơn nhiều so với độ dao động giữa các seed (0,28–0,31 điểm).
- Kích thước: 2.659 tham số chiếm 10.636 byte dạng float32; trọng số int8, bias int32 và một hệ số float32 cho mỗi kênh đầu ra chiếm 3.016 byte, nhỏ hơn 3,53 lần (không đúng 4 lần vì bias và hệ số vẫn rộng). \(\max|W|\) của từng tầng là 1,03; 1,07 và 1,06; ở tầng 1, cực đại hàng lớn nhất gấp 2,5 lần cực đại hàng nhỏ nhất.
7. Thí nghiệm 2 và 3: làm lưới thô hơn
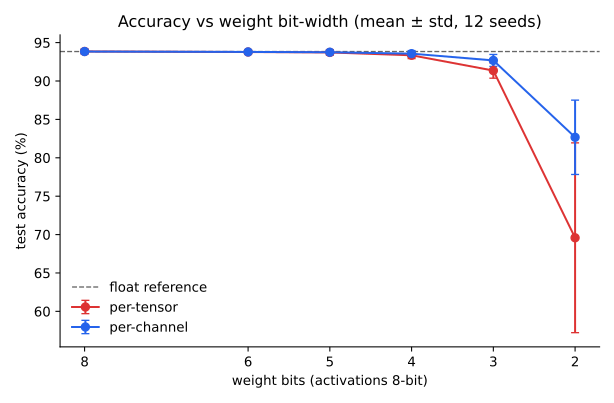
Cùng các mạng đã huấn luyện và cùng hiệu chỉnh, trọng số lượng tử hoá với ít bit hơn, kích hoạt giữ 8 bit.
| Số bit trọng số | Độ chính xác per-tensor (%) | Độ chính xác per-channel (%) | SQNR per-tensor (dB) | SQNR per-channel (dB) | \(6{,}02\,b\) (dB) |
|---|---|---|---|---|---|
| 8 | 93,84 ± 0,31 | 93,83 ± 0,28 | 40,0 | 44,1 | 48,2 |
| 6 | 93,77 ± 0,24 | 93,78 ± 0,28 | 27,7 | 31,9 | 36,1 |
| 5 | 93,72 ± 0,37 | 93,74 ± 0,26 | — | — | — |
| 4 | 93,35 ± 0,43 | 93,56 ± 0,39 | 14,9 | 19,0 | 24,1 |
| 3 | 91,36 ± 0,99 | 92,68 ± 0,78 | 7,6 | 11,7 | 18,1 |
| 2 | 69,58 ± 12,36 | 82,67 ± 4,84 | 0,9 | 3,2 | 12,0 |
Các cột SQNR đo trên trọng số của mạng seed 0 (gộp mọi tầng); các cột độ chính xác là trung bình ± độ lệch chuẩn trên 12 seed.
- Khoảng 6 dB mỗi bit, có độ lệch. SQNR per-tensor giảm từ 40,0 dB ở 8 bit xuống 27,7 dB ở 6 bit và 14,9 dB ở 4 bit, tức khoảng 6,2–6,4 dB mỗi bit, nhưng thấp hơn \(6{,}02\,b\) tới 8,2 dB ở 8 bit, vì lưới được định cỡ theo trọng số lớn nhất. Per-channel lấy lại 4,1 dB ở 8 bit.
- Độ chính xác gần như phẳng tới 5 bit và mất chưa tới nửa điểm ở 4 bit (93,35 % và 93,56 % so với 93,83 %) với bài toán nhỏ này, không huấn luyện lại.
- Độ mịn của hệ số có ý nghĩa khi lưới đã thô. Ở 3 bit, per-channel giữ 92,68 % so với 91,36 % của per-tensor; ở 2 bit là 82,67 ± 4,84 % so với 69,58 ± 12,36 %, với độ dao động giữa các seed của per-tensor lớn hơn nhiều.
Hạn chế. Dữ liệu là tổng hợp và bài toán dễ phân tách trong miền tần số; mạng rất nhỏ (2.659 tham số, chỉ có tầng dense). Tích chập kèm batch normalization và tầng depthwise có chênh lệch dải trọng số giữa các kênh lớn hơn nhiều, là nơi Krishnamoorthi (2018) thấy hệ số per-channel quan trọng nhất; thí nghiệm này không bao gồm chúng. Chỉ trọng số được quét số bit; kích hoạt giữ 8 bit với hiệu chỉnh min/max, vốn nhạy với giá trị ngoại lai trong dữ liệu thật. Hệ số requantization được áp dụng bằng số thực dấu phẩy động chứ không phải phép nhân-dịch bit dấu phẩy tĩnh, và không đo độ trễ hay năng lượng: đây là mô phỏng số học nguyên bằng số, không phải benchmark trên thiết bị. Việc có hỗ trợ hệ số per-channel hay không phụ thuộc vào runtime và bộ tăng tốc. Huấn luyện nhận biết lượng tử hoá (quantization-aware training), vốn Jacob và cs. (2018) kết hợp với sơ đồ số nguyên, chưa được thử.
8. Kết luận thực hành
- Bắt đầu bằng int8 sau huấn luyện: trọng số đối xứng per-channel, kích hoạt bất đối xứng per-tensor, đoạn giá trị lấy từ vài trăm đầu vào đại diện. Với bài toán này, độ chính xác thay đổi dưới 0,15 điểm ở mọi lần chạy.
- Hiệu chỉnh trên dữ liệu giống dữ liệu khi triển khai. Đoạn giá trị kích hoạt quyết định bước lượng tử của mọi tầng.
- So với mô hình số thực trên cùng tập kiểm tra và đếm cả độ trùng dự đoán, không chỉ độ chính xác: độ trùng (99,8 % ở đây) là phép kiểm tra nhạy rằng không có gì hỏng.
- Mỗi bit bỏ đi làm giảm khoảng 6 dB SQNR của trọng số; chỉ xuống dưới 8 bit sau khi đã đo trên bài toán của chính bạn, và ưu tiên hệ số per-channel khi làm vậy.
- Tính dung lượng bộ nhớ kể cả bias và hệ số (3,53× ở đây, không phải 4×), và kiểm tra runtime có hỗ trợ độ mịn hệ số bạn chọn.
Tôi nhận làm với tư cách freelancer. Mô tả dự án trong vài câu, tôi sẽ trả lời bằng các câu hỏi và báo giá trọn gói theo phạm vi cố định.
Nhận báo giá Xem dịch vụ
Tài liệu tham khảo
- B. Jacob, S. Kligys, B. Chen, M. Zhu, M. Tang, A. Howard, H. Adam và D. Kalenichenko. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2018, tr. 2704–2713. doi:10.1109/CVPR.2018.00286.
- R. Krishnamoorthi. “Quantizing deep convolutional networks for efficient inference: A whitepaper.” arXiv:1806.08342, tháng 6/2018. arxiv.org/abs/1806.08342. (Trọng số per-channel với kích hoạt per-layer; kết quả 8 bit sau huấn luyện; huấn luyện nhận biết lượng tử hoá.)
- P. Warden và D. Situnayake. TinyML: Machine Learning with TensorFlow Lite on Arduino and Ultra-Low-Power Microcontrollers. O’Reilly Media, 2020. ISBN 978-1-4920-5204-3.